
[테크톡노트] AI가 쓴 글로 AI 공부시키면…'모델 붕괴'란
AI 생성물 반복 학습하면 드문 정보 사라지고 성능 저하 우려
활용 방식 따라 학습 효과 달라…실제 데이터 확보·품질 검증 중요
(서울=연합뉴스) 유현민 기자 = 인공지능(AI)이 쓴 글을 다른 AI가 읽고 배운다면 더 똑똑해질까.
인터넷에 AI 생성물이 쌓이면서 AI가 만든 콘텐츠가 후속 모델의 학습 재료로 쓰일 때 어떤 일이 벌어지는지가 관심사로 떠올랐다.
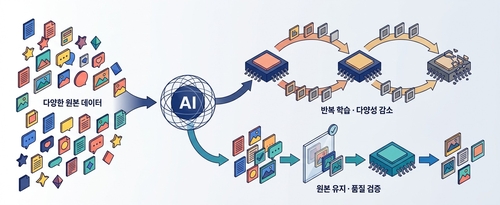
AI 생성물을 거듭 학습하는 과정에서 드문 정보나 예외적인 사례가 사라지고 성능이 떨어질 수 있다. 원래 데이터의 다양성과 특성을 점차 잃는 이런 현상을 '모델 붕괴'(Model Collapse)라고 한다.
다만 AI가 만든 데이터로 학습한다고 반드시 성능이 나빠지는 것은 아니다. 부족한 학습 자료를 보완하는 데도 쓰이는 만큼 실제 데이터를 유지하면서 생성 데이터의 품질을 검증하고 조합하는 방식이 중요하다.
◇ AI 생성물 반복 학습…희귀 정보부터 사라질 수 있어
대규모 언어모델(LLM)은 방대한 텍스트를 학습해 다음에 올 단어나 문장을 예측한다.
학습 데이터에는 흔히 쓰이는 표현뿐 아니라 드물게 등장하는 단어와 특수한 사례도 포함된다. 이런 다양성이 있어야 모델이 폭넓은 질문에 대응할 수 있다.
그러나 AI 생성물에 지나치게 의존하면 드문 표현이나 예외적인 사례가 후속 학습 데이터에서 빠질 수 있다.
이런 과정이 반복되면 모델이 생성하는 정보의 다양성이 줄고 원래 데이터의 특성에서 멀어질 가능성이 있다.
영국 옥스퍼드대와 케임브리지대 등의 연구진이 2024년 국제학술지 네이처에 발표한 논문에서는 모델이 생성한 데이터를 반복 학습할 때 원래 데이터 분포의 일부가 사라지는 현상이 확인됐다.
연구진은 이런 현상이 대규모 언어모델뿐 아니라 데이터의 잠재적 특성을 학습해 새로운 데이터를 생성하는 변분 오토인코더(VAE), 여러 확률분포를 조합해 데이터의 분포를 모델링하는 가우시안 혼합 모델(GMM) 등에서도 나타날 수 있다고 설명했다.
◇ 합성 데이터 활용은 가능…품질 관리가 관건
AI 생성 데이터를 학습에 활용하는 것 자체가 문제라는 뜻은 아니다. 실제 데이터만으로 확보하기 어려운 사례를 보완하거나 특정 작업의 성능을 높이는 데 합성 데이터가 쓰일 수 있다. 중요한 것은 원본 데이터의 다양성을 유지하면서 생성 데이터를 선별하고 활용하는 방식이다.
2025년 국제머신러닝학회(ICML)에 발표된 연구에서는 합성 데이터로 이전 세대의 학습 데이터를 계속 대체하면 모델 붕괴가 나타날 수 있는 것으로 나타났다. 반면 실제 데이터와 합성 데이터를 함께 누적해 학습하면 연구진이 시험한 조건에서 테스트 손실이 발산하지 않고 모델이 안정적으로 유지됐다.
이에 따라 사람이 만든 고품질 데이터를 지속해서 확보하고 학습 데이터의 출처와 생성 방식을 관리하는 일이 중요해지고 있다. 합성 데이터를 활용할 때도 중복과 오류, 편향을 점검하고 실제 데이터와 적절히 조합해야 한다.
모델 붕괴는 AI가 자기 결과물을 학습한다고 반드시 발생하는 현상은 아니다. 어떤 데이터를 얼마나 활용하고 품질을 어떻게 검증하는지가 관건이다. AI 생성물이 온라인 정보에서 차지하는 비중이 커질수록 학습 데이터의 신뢰성과 다양성을 지키는 일이 AI 발전의 중요한 과제로 떠오르고 있다.
hyunmin623@yna.co.kr
(끝)
<저작권자(c) 연합뉴스, 무단 전재-재배포, AI 학습 및 활용 금지>
AI 생성물 반복 학습하면 드문 정보 사라지고 성능 저하 우려
활용 방식 따라 학습 효과 달라…실제 데이터 확보·품질 검증 중요
(서울=연합뉴스) 유현민 기자 = 인공지능(AI)이 쓴 글을 다른 AI가 읽고 배운다면 더 똑똑해질까.
인터넷에 AI 생성물이 쌓이면서 AI가 만든 콘텐츠가 후속 모델의 학습 재료로 쓰일 때 어떤 일이 벌어지는지가 관심사로 떠올랐다.
AI 생성물을 거듭 학습하는 과정에서 드문 정보나 예외적인 사례가 사라지고 성능이 떨어질 수 있다. 원래 데이터의 다양성과 특성을 점차 잃는 이런 현상을 '모델 붕괴'(Model Collapse)라고 한다.
다만 AI가 만든 데이터로 학습한다고 반드시 성능이 나빠지는 것은 아니다. 부족한 학습 자료를 보완하는 데도 쓰이는 만큼 실제 데이터를 유지하면서 생성 데이터의 품질을 검증하고 조합하는 방식이 중요하다.
◇ AI 생성물 반복 학습…희귀 정보부터 사라질 수 있어
대규모 언어모델(LLM)은 방대한 텍스트를 학습해 다음에 올 단어나 문장을 예측한다.
학습 데이터에는 흔히 쓰이는 표현뿐 아니라 드물게 등장하는 단어와 특수한 사례도 포함된다. 이런 다양성이 있어야 모델이 폭넓은 질문에 대응할 수 있다.
그러나 AI 생성물에 지나치게 의존하면 드문 표현이나 예외적인 사례가 후속 학습 데이터에서 빠질 수 있다.
이런 과정이 반복되면 모델이 생성하는 정보의 다양성이 줄고 원래 데이터의 특성에서 멀어질 가능성이 있다.
영국 옥스퍼드대와 케임브리지대 등의 연구진이 2024년 국제학술지 네이처에 발표한 논문에서는 모델이 생성한 데이터를 반복 학습할 때 원래 데이터 분포의 일부가 사라지는 현상이 확인됐다.
연구진은 이런 현상이 대규모 언어모델뿐 아니라 데이터의 잠재적 특성을 학습해 새로운 데이터를 생성하는 변분 오토인코더(VAE), 여러 확률분포를 조합해 데이터의 분포를 모델링하는 가우시안 혼합 모델(GMM) 등에서도 나타날 수 있다고 설명했다.
◇ 합성 데이터 활용은 가능…품질 관리가 관건
AI 생성 데이터를 학습에 활용하는 것 자체가 문제라는 뜻은 아니다. 실제 데이터만으로 확보하기 어려운 사례를 보완하거나 특정 작업의 성능을 높이는 데 합성 데이터가 쓰일 수 있다. 중요한 것은 원본 데이터의 다양성을 유지하면서 생성 데이터를 선별하고 활용하는 방식이다.
2025년 국제머신러닝학회(ICML)에 발표된 연구에서는 합성 데이터로 이전 세대의 학습 데이터를 계속 대체하면 모델 붕괴가 나타날 수 있는 것으로 나타났다. 반면 실제 데이터와 합성 데이터를 함께 누적해 학습하면 연구진이 시험한 조건에서 테스트 손실이 발산하지 않고 모델이 안정적으로 유지됐다.
이에 따라 사람이 만든 고품질 데이터를 지속해서 확보하고 학습 데이터의 출처와 생성 방식을 관리하는 일이 중요해지고 있다. 합성 데이터를 활용할 때도 중복과 오류, 편향을 점검하고 실제 데이터와 적절히 조합해야 한다.
모델 붕괴는 AI가 자기 결과물을 학습한다고 반드시 발생하는 현상은 아니다. 어떤 데이터를 얼마나 활용하고 품질을 어떻게 검증하는지가 관건이다. AI 생성물이 온라인 정보에서 차지하는 비중이 커질수록 학습 데이터의 신뢰성과 다양성을 지키는 일이 AI 발전의 중요한 과제로 떠오르고 있다.
hyunmin623@yna.co.kr
(끝)
<저작권자(c) 연합뉴스, 무단 전재-재배포, AI 학습 및 활용 금지>
관련뉴스